DeepSeek-R1 671B
Полная MoE-модель для рассуждений, математики и кода. Веса распределяются между восемью H200.

6U · 8 × H200 SXM · NVIDIA HGX
GPU-сервер Dell PowerEdge для обучения моделей, распределённого инференса и HPC. Конфигурация NVIDIA HGX с восемью H200 SXM предоставляет 1128 ГБ памяти HBM3e, объединяя ускорители через NVLink. Стоечная платформа 6U с двумя Intel Xeon Scalable. CPU, оперативная память, накопители и сетевые адаптеры подбираются под задачи проекта.
Подготовим предложение под вашу комплектацию.
Отправная точка для выбора оборудования под вашу задачу.
Конфигурация: весь сервер с 8 × H200 SXM по 141 ГБ, всего 1128 ГБ HBM3e. Веса распределяются между GPU. Это оценка для инференса по объёму памяти, а не аппаратный тест. Контекст, KV-кэш, параллельные запросы и среда запуска требуют дополнительной памяти; обучение рассчитывается отдельно.
Полная MoE-модель для рассуждений, математики и кода. Веса распределяются между восемью H200.
Большая языковая модель для текстовых ассистентов. 16-битные веса распределяются между GPU сервера.
MoE-модель для текста, кода и рассуждений. В памяти размещаются все 235B параметров, с распределением между GPU.
BF16 — 16-битные веса. FP8 — 8-битная квантизация, которая сокращает расход памяти. Название модели ведёт на страницу её разработчика.
Примеры — оценка по памяти для инференса, а не результаты тестов на этом оборудовании. Дополнительно нужна память для контекста и среды запуска. Итог зависит от ПО, длины контекста и числа запросов; обучение и дообучение требуют отдельного расчёта. Подробнее о памяти
Представлена конфигурация XE9680 с H200 SXM5. CPU, RAM, SSD, сеть и сервисный пакет согласуются отдельно. Перед поставкой уточняются требования к стойке, электропитанию и охлаждению.
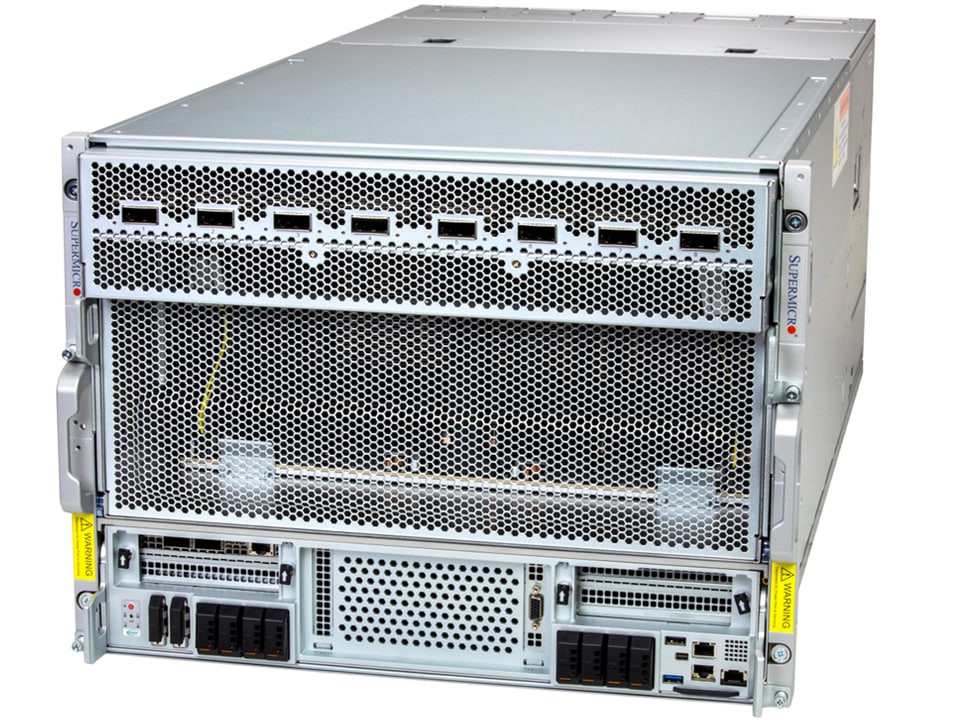
SYS-822GS-NB3RT · 8U · 8 GPU
AI-модели
Hopper · PCIe · серверный ускоритель
AI-модели
Server Edition · пассивное охлаждение
AI-модели